



こんにちは、三代です。
今回はAIによる高度な画像編集を試してみたいと思います。AIによる画像生成は既に広く話題になっていますが、新たな技術革新としてGoogleのGeminiで画像編集が可能になったので、そちらを試してみたいと思います!
画像生成と画像編集の違い
AIによる画像生成という文脈で言うと、画像生成と画像編集はどのように異なるのでしょうか。
例えば「train」というキーワードで以下の画像が生成できたとします。

右上の新幹線のような電車を左上の草原に走らせたいと考えたとします。今までは以下のようにプロンプトを調整して編集という名目のの新規作成を繰り返していました。
変更前
train
変更後
日本語:
「広大な緑の大草原を高速で走行する日本の新幹線、青い空と遠くの山々を背景に、鮮やかな日中の風景」
英語:
“A Japanese Shinkansen speeding through a vast green prairie, with a blue sky and distant mountains in the background, captured in a vibrant daytime scene”
詳細は以下の記事の画像生成の部分で扱っています。
上記調整したプロンプトで出来上がった画像はこちらです。

プロンプトに「山々」と入ってしまったので富士山らしきものがありますね。プロンプトが完璧でないということもありますが、そもそも画像をすべてテキストに置き換えて説明したうえで更に電車の指定までしていくというのはなかなか大変な作業です。
そうではなく、編集元の画像を参照したまま一部分だけを編集できるようになった!というものが今回のハイライトです。もちろん画像内から不要な要素を消すこともできます。俗に言う消◯ゴムマジックというやつです。
説明はここまでにして早速試してみましょう!
Google AI Studioを使う
今回新機能を試すのはGoogleが開発してるGeminiです。皆さんご存知のChatGPTやClaude 3.7 Sonnet と並んで比較されるLLM(大規模言語モデル)の一つです。
軽くGeminiについてご紹介させていただきます。
今回使うGeminiは開発者向けのもので、一般向けのGeminiとは異なります。
使うためにはGoogle AI Studioというサービスを利用します。
Googleアカウントのログインが求められた場合はご自身のアカウントでログインをしてください。無料ですので課金されることは有りません。
正しくログインできると以下のような画面に遷移します。

モデルがデフォルトだとGemini 2.0 Flashが選択されていると思うので、以下の画像を参考にImage Generationと書いてあるものを選択してください。

これで準備完了です!
以下の画像の機関車を新幹線にしてもらうようにお願いしてみましょう。

このようになりました。

いい感じですが、新幹線からの蒸気が出てしまっているので依頼を修正してみましょう。

いかがでしょうか。画像の大半の要素を保ったまま機関車の部分だけを新幹線にすることができました。若干左の草むらの雰囲気が変わっている感じもしますが、おそらく機関車の影が落ちていた部分に近いので変更されてしまった可能性はありますね。
では更に面白い機能を試してみましょう。
構図変更
新しくこちらの画像を用意しました。
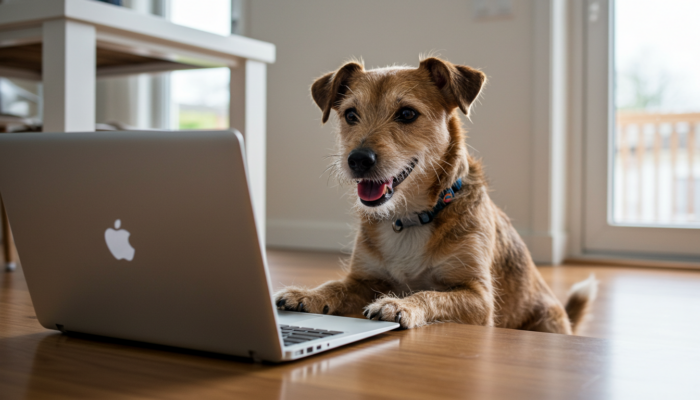
フリスビーをかっこよくキャッチするHow to動画を見ている犬の画像です。(想像)

現在犬に向かって右側から撮影している構図です。
これを向かって左側から撮影した画像がほしいとします。Geminiに頼んでみましょう!

このような感じになりました。(10回ほど調整済み)
プロンプトでやはり細かい調整は必要だと感じましたが、最終的に欲しい画が出せました。
効果的な画像生成プロンプトの書き方
基本的な操作方法

- プロンプトにマウスオーバーすると表示される星マークをクリックすることで画像を再生成できます
- ペンマークをクリックするとプロンプトを編集して再度生成依頼が可能です
プロンプト作成のポイント
AIは「相対的な位置関係」の理解が苦手です。例えば「少し右に行って」「回り込んで」といった人間同士のコミュニケーションで使う指示は誤解されやすいため、以下のような工夫が効果的です。
相対表現と絶対表現を組み合わせる
相対的な表現だけでなく、解釈の余地が少ない絶対的な表現も併用すると出力が安定します。
相対的な表現の例:
- 左側から撮影
- 斜め上からの画角
絶対的な表現の例:
- カメラを下に30度傾ける
- 犬の右側にパソコンが見えるように配置
- 猫と木が重なって見えるアングル
「見え方」を具体的に指定する
AIは3次元空間そのものというより、画面上の要素配置で認識をしています。何がどう見えるかを具体的に指示すると良い結果が得られます。今回の犬の画像を例に考えてみます。
効果的な指示の例:
- 「パソコンのロゴは見えるが画面は見えない角度」
- 「犬の顔と体の両方が見えるが、後ろ足は机に隠れて見えない角度」
- 「画面左に犬の顔、右にはパソコン画面裏のロゴ」
このように具体的な見え方を指定することで、AIはそれらを自然に配置するだけで良くなり、不自然な構図が生成される可能性が低くなります。パソコンのロゴが見える状態で犬の真横の顔が見えるというの破綻した画になるため、それを生成する可能性は低くなります。
他のユースケースを試してみましょう。
背景の人物削除
渋谷っぽい画像を用意しました。
たくさん人がいるのでそれらをすべて消してもらいます。

行き交う人をすべて消して無人にして
このように依頼したところ以下のようになりました。

人々が消え去りました。
編集範囲が大きくなればなるほど画質の劣化や細かい破綻もでてくるなと言った印象ですね。しかし既存の消◯ゴムマジックでは、この範囲の人物削除をすると確実に大きな破綻が起き、画像としては使えないものになっていたはずです。Geminiが編集した画像は少なくとも無人の渋谷として成立している画像にはなっていますね。
最後に面白い実験をしてみましょう。

このような服のデザインをしていたとします。これをモデルさんに着せてみてどんな雰囲気か見てみたくなったとします。それをGeminiに依頼してみましょう。


何回か生成をし直させましたが最終的にいい感じの画像が出来上がりました。
これを例えばアジア人にして、どこの場所で、どんなポーズで、と細かい指定まですると破綻が目立つようになりましたので、そこまではまだ性能が足りないようでした。今後のアップデートに期待ですね。
まとめ
今回はGoogle Geminiの新機能を試してみました。ポイントとしては今までは画像を編集したい時、ゼロから生成し直しが発生していたため、同一性、連続性が担保されていませんでした。今回出たGeminiはそれを解消し、画像の一部分だけを編集することが可能になりました。最終アウトプットの画質が少し悪くなってしまう問題や、毎回100点ものが出るわけではないというウィークポイントもありますが、公式リリース版になる頃には性能も上がっていると思いますので、そこに期待したいところです。
記事 三代


コメント